
SAST en profondeur : moteurs, taint et limites
Dans l'article découverte, on est resté côté comptoir : un barista trop obéissant, une goutte d'encre, un jeu.
Ici, on passe en cuisine, et ça va sentir l'huile de moteur.
Lancez trois outils SAST sur le même dépôtdépôt : l'endroit où vit le code d'un projet, avec son historique, par exemple sur GitHub : vous obtiendrez trois listes différentes. C'est le sujet de cet article : ce que chaque moteur construit à partir du code, ce qu'il suit, ce qui lui échappe, et pourquoi aucun ne sera jamais parfait. Il prolonge Le SAST expliqué simplement, mais se lit seul.
Rappel facultatif : une injection SQL pas à pas, avec une démo à essayer
Dans une vraie application, le comptoir est la base de donnéesbase de données : le logiciel qui range et retrouve les informations de l'application : clients, factures…, et la phrase criée est écrite dans un langage appelé SQL.
Voici un portail de factures fictif, avec trois clients. Cliquez d'abord sur MARTIN pour voir l'usage normal, puis sur ' OR '1'='1 : c'est la ruse qu'utiliserait un attaquant à la place d'un nom (OR veut dire « ou »).
Regardez ce que le programme envoie à la base : ce que vous avez tapé est surligné.
Portail factures · exemple fictif
Essayez :
Ce que le programme envoie à la base
SELECT * FROM factures WHERE client = 'MARTIN'Résultat
- N° 101MARTIN120 €
1 facture : celle de Martin. C'est l'usage prévu.
Voici la même question, en couleur selon qui l'a écrite :
client = '' OR '1'='1'
écrit par le programmetapé par l'attaquant
- L'attaquant commence par une apostrophe pour « sortir » des guillemets : elle les ferme tout de suite, et le nom recherché est vide.
OR '1'='1se retrouve hors des guillemets : ce n'est plus un nom, c'est une condition toujours vraie, donc toutes les factures sortent.- La dernière apostrophe, ajoutée par le programme comme toujours, referme le tout proprement.
Dans la version corrigée, c'est le formulaire avec sa case : la question part d'un côté, la saisie de l'autre. La base cherche un client qui s'appellerait vraiment ' OR '1'='1, n'en trouve aucun, et Martin retrouve toujours sa facture. (Un vrai portail vérifierait aussi l'identité de Martin et ses droits sur chaque facture.) On appelle cela une requête paramétrée.
L'application d'exemple
Voici trois fichiers d'une application web imaginaire, écrite en Python avec Flask, un outil courant pour créer des sites. Ils contiennent quatre vraies vulnérabilités et deux pièges : du code qui ressemble à une injection mais qui est sûr.
Avant de regarder ce que voient les outils, jouez l'analyseur : à vous de dire quelles lignes numérotées sont de vraies failles. Un bon analyseur signale les unes et se tait sur les autres.
4 vraies faillesL'outil doit les signaler
Mots de passe protégés par MD5MD5 : une ancienne fonction de hachage, trop faible pour protéger des mots de passe, méthode cassée et bien trop rapide.
Une injection SQL, entrée et sortie dangereuse dans la même fonctionfonction : un bloc de code qui porte un nom et accomplit une tâche précise.
Un nom de fichier pris dans l'adresse, qui permet de lire n'importe quel fichier du serveur.
Une injection SQL répartie sur deux fichiers différents.
2 piègesDu code sûr qui ressemble à une faille : l'outil doit se taire
Une saisie vérifiée contre une liste de valeurs autorisées : sûre.
Une requête construite avec une constanteconstante : une valeur fixée dans le programme, que l'utilisateur ne peut pas changer du programme : sûre.
Étape 1 : choisissez une configuration d'analyse
La configuration 1 cherche des formes de code : une requête SQL construite avec des chaînes, un chemin de fichier fabriqué en collant du texte, un hachage MD5. Elle ne détermine pas d'où viennent les valeurs.
La configuration 1 cherche des formes de code : une requête SQL construite avec des chaînes, un chemin de fichier fabriqué en collant du texte, un hachage MD5. Elle ne détermine pas d'où viennent les valeurs. La configuration 2 suit les données d'une source vers un sink, mais à l'intérieur d'une seule fonction, et prend tout échappement pour un sanitizer. La configuration 3 relie les fonctions entre elles, y compris d'un fichier à l'autre, grâce à un graphe d'appels et à des résumés de fonctions. La configuration 4 distingue les contextes : un échappement HTML ne protège pas un chemin de fichier. La configuration 5 comprend les contrôles du développeur, comme une liste blanche suivie d'unabort.
Étape 2 : regardez ce que cette configuration signale dans le code
trouvéeratéefausse alerte
def hacher(mot_de_passe):
L1 return hashlib.md5(mot_de_passe.encode()).hexdigest()@app.get("/commande")
def commande():
numero = request.args.get("id")
L2 sql = "SELECT * FROM commandes WHERE id = " + numero
return db.execute(sql)
@app.get("/recherche")
def recherche():
return trouver_produits(request.args.get("q"))
@app.get("/export")
def export():
nom = html.escape(request.args.get("f"))
L3 return open("/srv/exports/" + nom).read()
@app.get("/produits")
def produits():
tri = request.args.get("tri")
if tri not in ("nom", "prix"):
abort(400)
L4 return db.execute(f"SELECT * FROM produits ORDER BY {tri}")TABLE = "produits"
def trouver_produits(terme):
L5 return db.execute(f"SELECT * FROM {TABLE} WHERE nom LIKE '%{terme}%'")
def compter():
L6 return db.execute(f"SELECT COUNT(*) FROM {TABLE}")Comparez les configurations avec les boutons au-dessus du code. Le tableau résume leurs résultats sur ces six lignes :
| Configuration d'analyse | Failles trouvées (sur 4) | Fausses alertes (sur 2) |
|---|---|---|
| 1. Motifs | 4 | 2 |
| 2. Taint par fonction | 2 | 1 |
| 3. Entre fichiers | 3 | 1 |
| 4. Sanitizers par contexte | 4 | 1 |
| 5. Contrôles compris | 4 | 0 |
Un résultat limité à cet exemple.Ces cinq configurations fictives isolent des choix d'analyse (un outil réel les combine autrement), et le 4 sur 4 sans fausse alerte de la configuration 5 ne vaut que pour ces six lignes. Remplacez, par exemple, l'entrée Flask de L2 par un appel à portail.champ("client"), une API interne fictive inconnue du modèle de taint. Sans modèle reliant cet appel à une saisie externe, cette analyse peut manquer l'injection : le suivi entre fichiers et la reconnaissance des contrôles ne suffisent pas.
Deux mots pour juger un outil
La précision
La part de ses alertes qui sont de vraies failles : vraies alertes ÷ toutes les alertes. Basse précision = beaucoup de fausses alarmes.
Configuration 1 : 4 ÷ 6, soit 67 %.
Le rappel
La part des vraies failles qu'il trouve : failles trouvées ÷ failles existantes. Bas rappel = des failles ratées.
Configuration 1 : 4 ÷ 4, soit 100 %.
Un outil peut briller sur l'un et échouer sur l'autre : tout signaler donne un rappel parfait et une précision très basse, ne rien signaler ne donne aucune fausse alerte mais aucune faille trouvée. Le score OWASP Benchmark combine les deux : taux de vrais positifs − taux de faux positifs. Tout signaler vaut 100 % − 100 % = 0.
Configuration 1 : les motifs trouvent tout, et un peu trop
4 failles sur 42 fausses alertes
Un jeu de règles de motifs classique cherche des formes : « une requête SQL fabriquée en collant des morceaux de texte », « un fichier ouvert avec un chemin fabriqué de la même façon », « un appel à MD5 ». Sur notre application, il trouve les quatre vulnérabilités, mais signale aussi L4 et L6, qui ont exactement la forme d'une injection sans en être une. Il ne sait pas d'où viennent les valeurs.
Configuration 2 : le taint fait taire le bruit, et perd des failles
2 failles sur 41 fausse alerte
L'analyse de taint ajoute la question qui manquait : d'où vient la valeur ? TABLE est une constante, donc L6 disparaît. L2 reste trouvée, car l'entrée et la sortie dangereuse sont dans la même fonction, et L1 (MD5) aussi : c'est une règle de motif, que le taint ne remplace pas.
Mais deux vulnérabilités tombent. L5, parce que l'entrée est dans routes.py et la sortie dangereuse dans depot.py : un outil qui analyse fonction par fonction ne relie pas les deux. Et L3, parce que la valeur passe par html.escape, qu'un outil qui ne distingue pas les contextes prend pour un sanitizer.
C'est le piège de cette configuration : le bruit baisse (1 fausse alerte au lieu de 2), mais la précision ne bouge pas (2 alertes justes sur 3, contre 4 sur 6) et le rappel chute. Moins d'alertes ne veut pas dire de meilleures alertes. Pour situer les moteurs connus, voyez Choisir un SAST sans se faire avoir.
Configuration 3 : suivre la donnée d'un fichier à l'autre
3 failles sur 41 fausse alerte
Pour retrouver L5, l'outil doit relier deux fichiers :
routes.py
recherche() lit la saisie du visiteur et la passe à trouver_produits().
depot.py
trouver_produits() colle son paramètreparamètre : la valeur que l'on donne à une fonction quand on l'appelle dans une requête SQL.
Il lui faut un graphegraphe : un schéma de points reliés par des flèches ; ici, qui appelle qui dans le programme d'appels, la carte de « qui appelle qui » dans le programme, et des résumés de fonctions : une fiche par fonction qui dit « mon premier paramètre arrive dans une requête SQL ». Le résumé est calculé une fois, puis réutilisé à chaque appel, ce qui permet de passer à l'échelle.
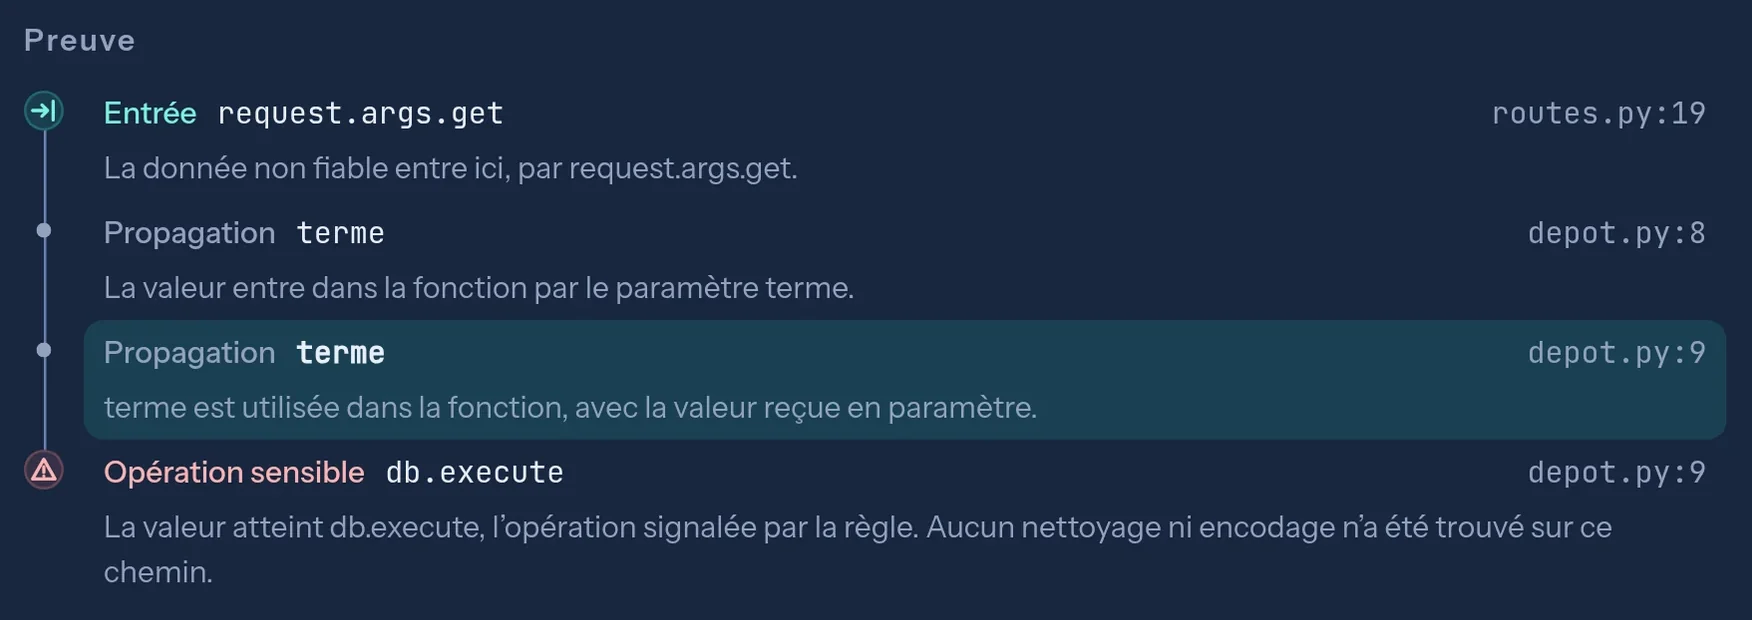
routes.py jusqu'à db.execute dans depot.py, en passant par le paramètre terme. C'est L5.La difficulté, c'est la carte elle-même. Ici, l'appel est direct ; dans une vraie application, il passe souvent par des mécanismes indirects, où la fonction réellement appelée n'est connue qu'à l'exécution. La façon dont chaque outil devine « qui appelle qui » explique une bonne part des écarts entre outils.
Configuration 4 : un sanitizer ne vaut que pour son contexte
4 failles sur 41 fausse alerte
Une protection ne vaut que pour les usages et hypothèses prévus :
| Sanitizer | Protège | Ne protège pas |
|---|---|---|
html.escape | Du texte affiché dans une page HTMLHTML : le langage qui décrit le contenu des pages web | Un chemin de fichier comme ../../etc/passwd |
| Requête paramétrée | Une requête SQL | Une commande envoyée au serveur |
| Contrôle du chemin résolu | L'ouverture d'un fichier, si le chemin résolu reste dans le dossier autorisé (liens symboliques et accès concurrents compris) | Une requête SQL |
../../etc/passwd remonte dans les dossiers du serveur jusqu'à un fichier sensible, et html.escape le laisse passer. Pour retrouver L3, l'outil doit associer chaque sanitizer au type d'opération qu'il protège.
À retenir :un outil qui rate L3 ne signale rien, et rien ne ressemble plus à du code sûr qu'une vulnérabilité ratée. C'est un des écarts les plus nets entre outils, et un des plus durs à voir dans une démo.
Configuration 5 : comprendre les contrôles du développeur
4 failles sur 40 fausse alerte
L4 est sûre : la valeur de tri est vérifiée contre une liste de valeurs autorisées avant d'arriver dans la requête. Pour se taire, l'outil doit comprendre que la ligne abort(400), qui renvoie une erreur au visiteur, coupe le chemin, et que la valeur qui arrive dans la requête ne peut valoir que nom ou prix.
Cette configuration reconnaît le contrôle de notre exemple. Les contrôles réels prennent des formes très variées : vérification par un motif de texte, conversion en nombre, fonction écrite par l'équipe. Un outil honnête permet de déclarer ses propres sanitizers et de marquer une alerte comme fausse, en gardant une trace écrite de la décision.
Sous le capot : du texte au graphe
Un SAST ne lit pas le code comme vous lisez cet article. Il le transforme d'abord en une série de représentations, chacune capable de répondre à une question différente. Prenons cinq lignes :
def recherche():
    q = request.args.get("q")
    if not q:
        q = "café"
return db.execute("SELECT * FROM produits WHERE nom = '" + q + "'")- AST
L'arbre syntaxique, c'est la grammaire :
db.execute(…)est un appel, dont l'argument est une concaténation de trois morceaux. Les règles de la configuration 1 travaillent ici, sans savoir d'où vientq. - CFG
Le graphe de flot de contrôle, c'est l'ordre possible d'exécution : après le
if, deux chemins se séparent puis se rejoignent. Soitqvient de l'adresse, soit il vaut « café ». - SSA
La forme SSA (Static Single Assignment) donne un nom neuf à chaque affectation :
q₁ = request.args.get("q"),q₂ = "café", et au point de jonctionq₃ = φ(q₁, q₂), « l'un ou l'autre selon le chemin pris ». Un φ qui mélange de l'encre et de l'eau claire donne de l'encre : alerte. - Appels
Le graphe d'appels relie les fonctions entre elles, d'un fichier à l'autre. C'est lui qui permet à la configuration 3 de retrouver L5.
Joern pousse l'idée au bout : il superpose l'arbre, le flot de contrôle et les dépendances de données en un seul graphe, le code property graph (Yamaguchi et ses coauteurs, 2014). Chercher une faille de taint revient alors à chercher dans ce graphe un chemin de la source au sink qui ne traverse aucun sanitizer. Plus la représentation est riche, plus l'outil voit loin, et plus il coûte en mémoire et en temps.
Le taint, version longue
Un moteur de taint a besoin de quatre listes, et leur qualité compte autant que le moteur lui-même :
| Liste | Rôle | Exemples en Python |
|---|---|---|
| Sources | Où l'encre apparaît | request.args, request.form, en-têtes, cookies, fichiers envoyés |
| Sinks | Où l'encre devient dangereuse | cursor.execute, subprocess.run(…, shell=True), open, pickle.loads, render_template_string |
| Sanitizers | Où l'encre s'arrête, pour un sink donné | paramètres de requête SQL (sûrs pour cet appel, sans « laver » la valeur pour la suite), int(), shlex.quote pour un argument de shell POSIX |
| Propagateurs | Où l'encre passe d'une valeur à une autre | +, f-strings, .format, " ".join, list.append, dict.get |
Les propagateurs sont les grands oubliés : si l'outil ne sait pas que " ".join(morceaux) transmet l'encre de la liste au texte, le chemin s'arrête net, et la faille disparaît du rapport sans un bruit.
Ensuite viennent les sensibilités : ce que le moteur accepte de distinguer. Chacune retire des fausses alertes, et chacune se paie.
Au flot : l'ordre compte
x = request.args["x"]
x = "fixe"
db.execute(x)
Un moteur insensible au flot voit « x a été contaminé un jour » et alerte. À tort : au moment de l'appel, x vaut « fixe ».
Aux champs : l'objet n'est pas un bloc
u.nom = request.args["n"]
u.role = "client"
db.execute("… " + u.role)
Sans sensibilité aux champs, tout u est contaminé, u.role compris. Fausse alerte.
Au contexte : qui appelle compte
a = propre(request.args["q"])
b = propre("SELECT 1")
db.execute(b)
Un moteur qui fusionne tous les appels à propre conclut que son retour est contaminé, y compris pour b. Un résumé « le retour est contaminé si le paramètre l'est » règle le problème.
Aux chemins : les gardes comptent
if tri not in ("nom", "prix"):
    abort(400)
db.execute(f"… ORDER BY {tri}")
C'est L4, le piège de la configuration 5 : après le abort, tri ne peut valoir que deux constantes.
Pour les curieux : la théorie derrière les résumés
Les moteurs modernes calculent des résumés de fonctions, puis recommencent jusqu'à ce que plus rien ne change (un point fixe). La théorie classique, IFDS (Reps, Horwitz et Sagiv, 1995), ramène le problème à une question d'accessibilité dans un graphe : peut-on aller de la source au sink en respectant l'ordre des appels et des retours ?
À retenir :« nous faisons du taint » ne veut presque rien dire. Demandez lesquelles de ces sensibilités l'outil gère, et sur quelles listes il s'appuie pour vos frameworks.
Pourquoi aucun SAST n'est parfait (et ne le sera jamais)
Ce n'est pas un manque de talent des éditeurs, c'est des mathématiques.
Le théorème de Rice (1953) dit qu'aucun programme ne peut décider, pour tous les programmes, une propriété non triviale de leur comportement.
« Ce programme peut-il envoyer une saisie dans une requête SQL ? » en est une.
Chaque outil doit donc choisir de quel côté se tromper :
Sur-approximer
- PrincipeSignaler tout ce qui pourrait arriver.
- PrixDes faux positifs.
Sous-approximer
- PrincipeNe signaler que ce qu'on est sûr d'avoir vu.
- PrixDes faux négatifs.
En pratique, les outils industriels mélangent les deux selon les endroits. Des chercheurs ont même inventé un mot pour ça, la soundiness (« In Defense of Soundiness », Livshits et ses coauteurs, 2015) : rigoureux partout, sauf là où la rigueur coûterait trop cher, par exemple face à eval ou à la réflexion.
À retenir :un SAST garanti exact sur tous les programmes résoudrait le problème de l'arrêt. Si son éditeur l'avait vraiment, il ne serait pas sur un stand de salon, il recevrait le prix Turing.
Ce qui casse les outils dans la vraie vie
Notre application piégée tient en trois fichiers propres. Le vrai code, lui, est plein de choses qui font perdre la trace de l'encre :
- Les frameworks.En Flask, les entrées s'appellent
request.args; en Django,request.GET; en Spring, un paramètre annoté@RequestParam. Sans le modèle du framework, l'outil ne sait même pas où sont les sources : les modèles de frameworks sont le vrai produit. - L'injection de dépendances.En Spring, l'objet réellement appelé est choisi au démarrage, d'après la configuration. Le graphe d'appels est alors deviné, pas lu.
- La réflexion et le code dynamique.
getattr(objet, nom)(),eval, les imports calculés, les décorateurs qui enveloppent une fonction : autant d'appels dont la cible peut être difficile, voire impossible, à deviner sans exécuter le code. - Les ORM et les gabarits.
Produit.objects.filter(nom=q)est paramétré ;Produit.objects.raw("…" + q)ne l'est pas. Jinja2, dans Flask, échappe le HTML par défaut dans les gabarits.html, mais un|safeou unMarkup()coupe la protection. L'outil doit connaître chaque variante. - Ce qu'il ne lit pas.Du code généré, minifié, un langage non pris en charge, un fichier trop gros, une syntaxe trop récente pour l'analyseur : souvent, l'outil passe en silence.
Les modèles de langage aident à lire un chemin (en 2024, Big Sleep de Google a trouvé une faille mémoire dans SQLite avant publication), mais ils peuvent inventer une protection : un « faux positif » sans preuve ne vaut rien. Le bon partage : le moteur fournit le chemin, l'IA aide à le lire, un humain tranche, et la décision s'écrit.
Pour conclure
Trois outils, trois listes : l'écart ne tient pas au nombre d'alertes, mais à ce que chaque moteur sait modéliser (le trajet d'un fichier à l'autre, le contexte d'un sanitizer, les contrôles du développeur) et à ce qu'il reconnaît ne pas avoir lu. Aucun ne sera parfait, Rice y veille. Préférez celui qui montre le chemin complet de chaque alerte et dit clairement où il s'est arrêté : combien de fichiers analysés, combien ignorés, et pourquoi.
Les mots de cet article · 11 mots
- Précision
- La part des alertes d'un outil qui sont de vraies failles.
- Rappel
- La part des vraies failles qu'un outil trouve.
- Motif
- Une forme de code recherchée telle quelle, sans savoir d'où viennent les valeurs.
- Taint
- Le suivi d'une donnée de l'entrée jusqu'à l'opération dangereuse.
- Graphe d'appels
- La carte de « qui appelle qui » dans un programme.
- Résumé de fonction
- Une fiche qui dit ce qu'une fonction fait des données qu'elle reçoit.
- Sanitizer
- Ce qui rend une donnée sûre pour un type d'opération précis.
- OWASP
- Une fondation à but non lucratif qui publie des ressources de sécurité applicative.
- AST, CFG, SSA
- L'arbre syntaxique, le graphe de flot de contrôle, et la forme où chaque affectation porte un nom unique.
- Sensibilité
- Ce qu'un moteur accepte de distinguer : l'ordre des instructions, les champs d'un objet, le contexte d'appel, les chemins.
- Propagateur
- Une opération qui fait passer l'encre d'une valeur à une autre, comme une concaténation.
Pour choisir un outil (moteurs du marché, bancs d'essai, questions à poser) : Choisir un SAST sans se faire avoir. Pour revoir les bases : Le SAST expliqué simplement.
Et pour les briques que votre code importe : SCA : de l'inventaire à la priorité.
Lire ensuite : Choisir un SAST sans se faire avoir